Știința Antrenamentului
Seria: STRONGMAN DATA LAB: CUM MĂSURĂM ȘI ANALIZĂM PERFORMANȚA - Episodul 9: Modele statistice de estimare a performanței
15 octombrie 2026
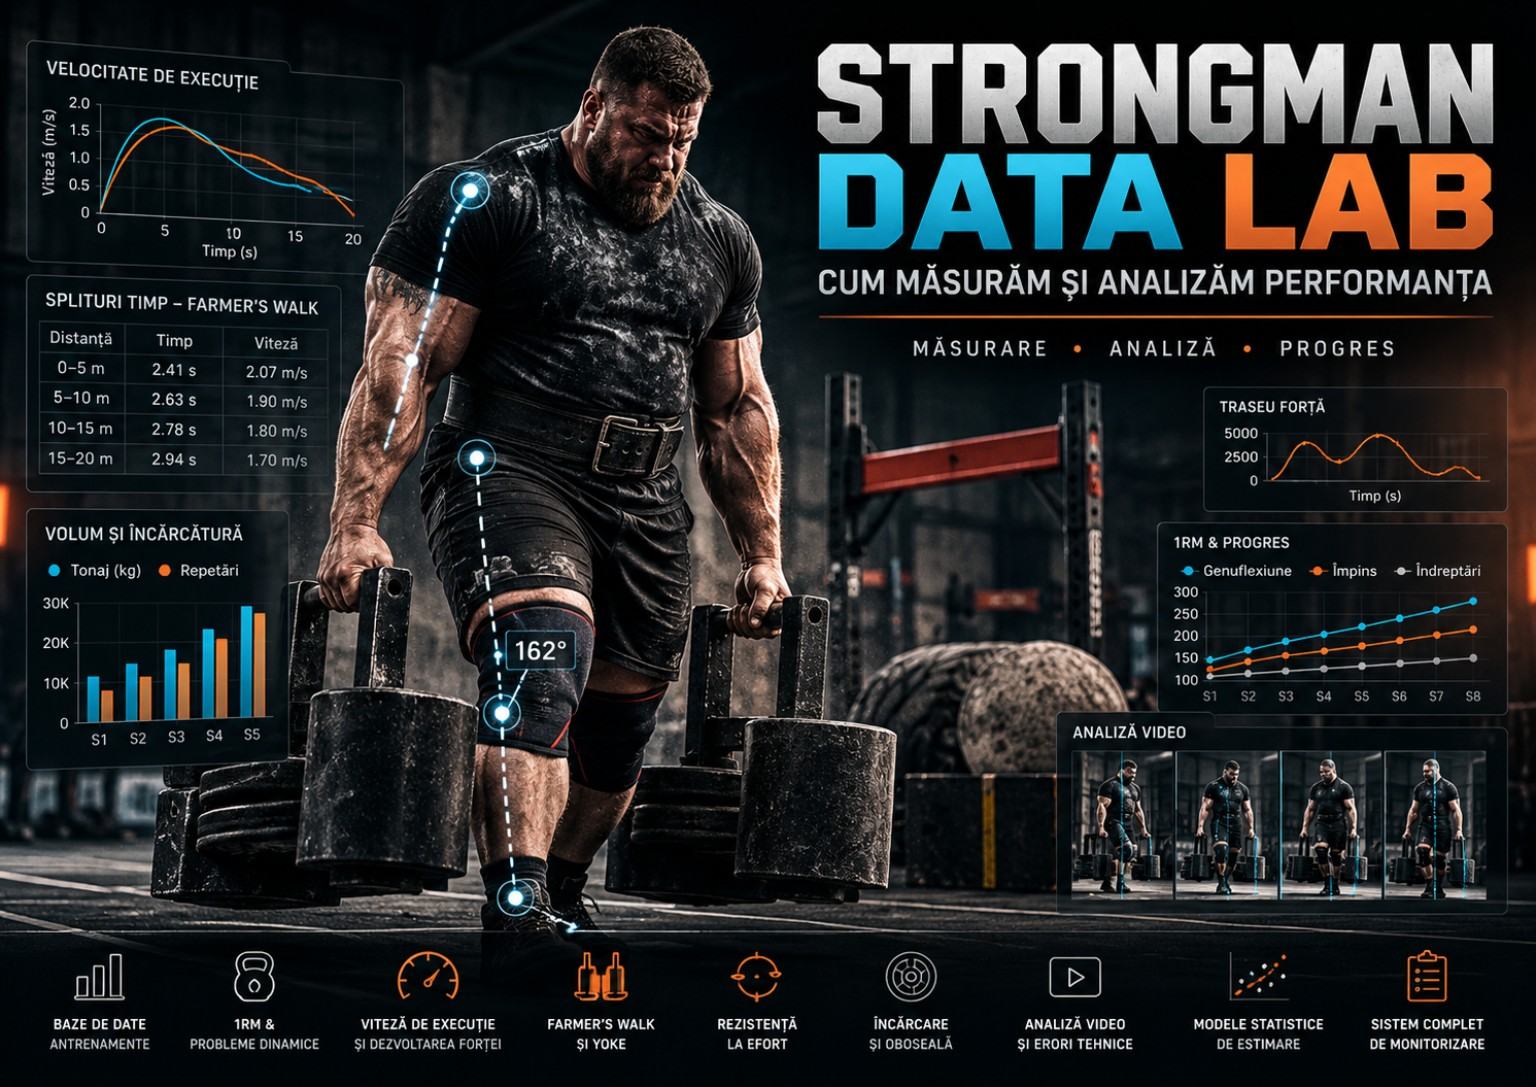
O competiție de strongman începe cu mult înaintea primei probe. În antrenament, un sportiv se întreabă dacă va reuși să ridice noua încărcătură la Deadlift, dacă timpul său la Yoke poate scădea cu două secunde ori dacă șase repetări la Log vor deveni opt. Datele ultimelor luni oferă indicii, dar nu un răspuns sigur. Există zile foarte bune, accidentări, schimbări de aparatură și reguli. Între ce s-a întâmplat și ce se va întâmpla există incertitudine, iar statistica ne ajută să o descriem fără să o ascundem.
Acesta este episodul nouă din seria STRONGMAN DATA LAB: CUM MĂSURĂM ȘI ANALIZĂM PERFORMANȚA. După construirea bazei de date, analiza vitezei, a probelor de transport și repetitive, monitorizarea încărcării și studiul video al mișcărilor, trecem la întrebarea care atrage cel mai mult atenția: putem anticipa performanța viitoare? Vom discuta despre statistica descriptivă, regresie, erori, modele cu mai multe variabile, predicții pentru concursuri și limitele inteligenței artificiale atunci când rezultatele provin dintr-un număr mic de încercări.
Vom folosi modele explicabile și exemple numerice, dar nu vom prezenta o ecuație universală a puterii unui strongman. Două trasee de Farmer’s pot avea aceeași lungime, dar suprafețe și mânere diferite. Un record de Deadlift obținut la o bară standard nu determină exact performanța cu axle. O prognoză are sens numai în raport cu proba, regulamentul, momentul sezonului și gradul de similitudine cu datele pe care se bazează. Literatura despre biomecanica strongman subliniază diversitatea acestor sarcini [1], iar cercetarea modernă asupra modelelor predictive insistă asupra validării și raportării transparente [2].
Toate studiile de caz și seriile de rezultate construite pentru explicații în acest articol sunt **ipotetice**. Ele ilustrează metoda, nu pretind că provin de la persoane reale sau dintr-un experiment desfășurat de noi. Când invocăm publicații, vom preciza ce principiu susțin și unde extrapolăm din statistică ori din alte domenii către strongman. Scopul nu este să impresionăm cititorul cu formule, ci să construim o metodă prin care predicția devine o întrebare verificabilă, iar eroarea un rezultat important, nu o problemă ascunsă.
1. Predicția nu este explicație: două obiective diferite
În analiza performanței, explicația încearcă să identifice mecanisme și relații relevante. Predicția urmărește să estimeze un rezultat viitor cât mai bine, folosind informații disponibile înainte ca acel rezultat să apară. Un model poate prezice destul de bine timpul la Farmer’s din încărcătură, distanță și timpi precedenți, fără să demonstreze că una dintre aceste variabile este cauza modificării vitezei. Invers, o explicație biomecanică solidă nu produce obligatoriu o prognoză numerică precisă pentru următoarea competiție.
Să presupunem că observăm o relație între numărul sesiunilor de Log și repetările valide din concurs. Sportivii mai experimentați se pot antrena mai des și pot avea în același timp forță mai mare, tehnică mai bună sau alte avantaje. Dacă asocierea este puternică, modelul poate utiliza frecvența ca predictor, dar nu rezultă că suplimentarea automată cu două sesiuni săptămânale va provoca același progres. Aceasta ar fi o afirmație cauzală, care cere un alt design de cercetare.
Un program de predicție poate fi evaluat prin comparația dintre valorile anticipate și rezultatele observate ulterior. Un program explicativ necesită și argumente despre mecanisme, confuzii posibile și intervenții. Cele două pot colabora: o teorie tehnică sugerează ce variabile merită introduse într-un model, iar greșelile predicțiilor pot indica faptul că teoria a omis ceva. Dar nu sunt sinonime și nu trebuie judecate după aceleași criterii.
Pentru un Strongman Data Lab, prima întrebare este «ce decizie vrem să susținem?». Estimarea timpului la Yoke poate influența alegerea unei strategii; identificarea motivului pentru care Yoke este lent poate influența pregătirea tehnică. Dacă nu facem această distincție, riscăm să transformăm coeficienții de regresie în recomandări cauzale nejustificate.
2. Definirea rezultatului: ce anume încercăm să anticipăm?
Un model statistic are nevoie de o variabilă-țintă clar definită. La Deadlift for Max putem estima greutatea maximă validată, dar nu trebuie să o confundăm cu cea mai grea încercare efectuată. La Log for Reps putem estima numărul de repetări acceptate în 75 secunde, nu doar numărul mișcărilor începute. La Farmer’s putem estima timpul până la linia de sosire, cu regula de start și oprire precizată. La o competiție putem estima punctele obținute într-o anumită probă, dar punctajul depinde de adversari și de regulament.
Dacă alegem ca obiectiv «forța», avem o noțiune prea largă. Un sportiv poate avea Deadlift maximal excelent și dificultăți la Atlas Stones. O formulă construită pe Squat și Bench nu devine automat un predictor al tuturor probelor. De aceea păstrăm separate rezultatele la ridicări maximale, repetări contra timp, deplasări, încărcări și medleys. Abia apoi putem construi un profil competițional fără să pretindem că toate exprimă aceeași calitate.
Exemplu ipotetic: ținta este timpul oficial pentru Yoke 320 kg pe 20 metri, cu start din repaus și fără penalizări suplimentare. Un set de date pentru aceeași sarcină și distanță poate fi comparabil dacă suprafața și cadrul rămân similare. Dar o probă de 340 kg pe 15 metri nu este o observație de aceeași natură fără o modelare explicită a diferențelor. Definițiile trebuie stabilite înaintea colectării datelor, nu ajustate ca să obținem un model care arată bine.
O țintă poate fi continuă, precum timpul sau masa validată; discretă, precum numărul de repetări; binară, precum valid versus invalid; sau ordonată, precum locul în clasament. Tipul ei influențează metoda statistică. Nu aplicăm aceeași ecuație liniară fără verificări tuturor, iar alegerea modelului trebuie să urmeze întrebarea sportivă.
3. Unitatea de analiză: repetiție, sesiune, atlet sau concurs?
În aceeași bază de date, o repetiție este legată de un set, setul de o sesiune, iar sesiunea de un sportiv. Dacă fiecare încercare este tratată ca independentă, putem exagera masiv volumul informației. O sută de repetări de la același atlet nu reprezintă același lucru cu o sută de atleți. Observațiile unui singur sportiv împart aceeași antropometrie, istorie de pregătire și multe condiții de testare.
Pentru predicția timpului viitor al unui atlet, unitatea naturală poate fi cursa standardizată, cu atenție la dependența dintre cursele consecutive. Pentru comparații între competitori, poate fi sportivul sau atletul în concurs. Pentru estimarea succesului unei repetări, unitatea poate fi încercarea, dar ordinea ei în set trebuie inclusă. Fiecare alegere schimbă semnificația numărului de date și a erorii statistice.
Să presupunem că avem 15 sportivi, fiecare cu 20 de încercări Log. Tabelul conține 300 de rânduri, însă nu avem 300 de persoane independente. Dacă împărțim aleatoriu rândurile între antrenare și test, încercările fiecărei persoane ajung în ambele seturi. Un algoritm poate recunoaște caracteristici individuale și poate părea foarte bun, fără să prezică bine un atlet nou. Pentru evaluarea generalizării la persoane noi, separarea trebuie realizată la nivel de sportiv.
Într-un proiect centrat pe un singur atlet, problema se schimbă: putem folosi serii temporale, dar nu trebuie să tratăm sesiunile apropiate ca observații complet independente. O schimbare de program sau o accidentare poate influența mai multe zile consecutive. Organizarea ierarhică a datelor nu este un detaliu tehnic, ci condiția interpretării corecte.
4. Calitatea datelor înaintea oricărui algoritm
Un model sofisticat nu poate recupera automat sensul unor înregistrări incomplete. Dacă unele curse Farmer’s au masa notată per mână și altele totală, modelul poate interpreta diferența de convenție drept schimbare reală. Dacă o încercare invalidă de Deadlift este introdusă ca zero kilograme, o medie poate deveni absurdă. Dacă un cronometru pornește la semnal și altul la prima mișcare, timpii nu mai sunt direct comparabili.
Un registru bun conține identificatorul sportivului, data, proba, varianta, masa și unitatea, distanța ori durata, statutul oficial, modul de cronometrare și eventualele condiții schimbate. Metadatele nu sunt informații secundare; ele permit definirea corectă a grupurilor de observații. Înainte de ajustarea modelului, verificăm duplicatele, valorile imposibile, inconsecvențele de unitate și câmpurile lipsă. Nu înlocuim automat orice celulă lipsă cu zero.
Exemplu: într-un set pentru Log, o înregistrare cu 11 repetări în 60 secunde și una cu 11 în 90 secunde nu au același înțeles. Nu le comparăm direct fără durata probei. Dacă durata este necunoscută, observația poate fi exclusă dintr-un model care depinde de ea, dar păstrată în arhiva originală. O decizie de excludere trebuie documentată, nu făcută retrospectiv pentru a îmbunătăți graficul.
Publicarea unei prognoze credibile începe cu descrierea populației și a calității datelor, așa cum recomandă principiile de raportare transparentă a modelelor predictive [2]. Aceste principii provin în parte din cercetarea medicală, nu sunt o validare specifică pentru strongman; le utilizăm ca standard metodologic pentru a evita opacitatea rezultatelor.
5. Statistică descriptivă: înainte de regresie, înțelegem distribuția
Media, mediana, minimul, maximul și dispersia unui set sunt puncte de plecare. Dacă timpii Yoke ai unui atlet sunt 18,1, 17,8, 18,4, 20,9 și 18,0 secunde, media este influențată de cursa neobișnuit de lentă. Mediana poate descrie mai bine încercarea tipică, dar nu trebuie să ascundem întâmplarea în care sportivul a avut dificultăți. Poate exista o cădere a cadrului, o eroare de cronometrare sau o problemă reală de control. Fiecare explicație are consecințe diferite.
Dispersia arată cât de mult variază performanța, nu doar nivelul ei central. Doi sportivi cu medie de 20 secunde pot avea fiabilități diferite: unul între 19,8 și 20,2, altul între 17 și 23. În concurs, constanța poate fi valoroasă când o încercare foarte lentă costă puncte. Totuși, trebuie să comparăm încercări efectuate în condiții similare înainte să declarăm că unul este «mai stabil».
Graficele de distribuție și evoluție în timp pot revela erori sau schimbări de fază. Dacă toate rezultatele se îmbunătățesc brusc după schimbarea aparatului, trebuie să verificăm configurația. Dacă apar două grupuri de timpi, poate că unul se referă la asfalt și altul la cauciuc. O regresie aplicată imediat tuturor ar putea învăța o relație falsă. Explorarea descriptivă este un control al validității întrebării.
Într-un raport, prezentăm câte observații sunt disponibile, intervalul de date, condițiile și măsura dispersiei. O medie izolată, lipsită de context, poate crea o impresie de certitudine pe care datele nu o au. Statistica descriptivă bine făcută este fundația modelelor ulterioare, nu un capitol introductiv dispensabil.
6. Eroarea de măsurare nu este același lucru cu variația reală
Rezultatele diferă între zile din cauze reale și din cauze de măsurare. Un cronometru manual poate adăuga variație de reacție, iar o aplicație video poate identifica diferit momentul desprinderii. Atletul însuși poate modifica tehnica sau poate fi mai obosit. Atkinson și Nevill au descris diferențele dintre erorile sistematice și cele aleatoare în variabile folosite în medicina sportivă [3]. Un model care nu distinge aceste componente riscă să trateze zgomotul drept schimbare fiziologică.
Să presupunem că o cursă Farmer’s scade de la 17,9 la 17,8 secunde. Diferența poate fi prea mică pentru metoda de cronometrare. Dacă însă rezultatul trece de la 18,2 la 16,7 secunde în mai multe curse standardizate, avem dovezi mai puternice ale unei schimbări relevante. Nu rezultă automat care adaptare a produs-o, dar incertitudinea de măsurare devine mai puțin dominantă.
Fiabilitatea testului trebuie estimată prin repetări adecvate, fără să uităm că repetările consecutive pot induce oboseală și familiarizare. Un test complet maximal este costisitor; nu organizăm competiții repetate doar pentru a calcula o deviație standard. Putem utiliza repere submaximale sau cronometrarea independentă a acelorași filmări pentru a evalua componente distincte ale erorii.
În predicție, eroarea datelor-țintă limitează performanța maximă practică a modelului. Dacă timpii sunt măsurați inconsistent, un algoritm foarte complex va ajusta uneori particularitățile cronometrelor, nu capacitatea sportivului. Investiția într-un protocol consecvent poate avea valoare mai mare decât adăugarea unei rețele neuronale.
7. Schimbarea relevantă: când progresul merită să influențeze programul
Nu orice diferență numerică este importantă pentru competiție. O scădere de 0,1 secunde la Farmer’s poate fi decisivă într-un clasament strâns, dar numai dacă metoda are rezoluția și fiabilitatea necesare pentru a o distinge. O repetare suplimentară la Log poate schimba locul în clasament, deși reprezintă o unitate discretă și poate apărea doar pentru că sportivul a ajuns la lockout cu o fracțiune de secundă înainte de limită. Importanța sportivă și certitudinea statistică sunt concepte diferite.
Într-un grafic longitudinal putem marca o zonă care reflectă variația obișnuită a testului, fără să o numim automat «prag de risc» sau «limită de progres». Dacă media timpului Yoke pare să se îmbunătățească treptat, verificăm dacă modificarea depășește fluctuațiile testului. Dacă nu, putem continua monitorizarea fără să declarăm succesul sau eșecul unui program. Absența dovezii unui progres nu este dovada că adaptarea a fost zero.
Uneori relevanța este stabilită de regulile competiției, nu de un prag statistic universal. Într-un Deadlift for Reps, trecerea de la șapte la opt repetări poate fi mai importantă decât reducerea cu o secundă a timpului până la ultima repetare, dacă departajarea se face numai prin număr. În alte concursuri, timpul ultimei validări este criteriu de tie-break. Modelul trebuie să anticipeze ceea ce afectează cu adevărat clasamentul.
Pentru fiecare indicator vom specifica unitatea, variabilitatea cunoscută și decizia pe care o poate influența. Așa evităm «progrese» exprimate procentual fără sens. O statistică este utilă când se conectează la o alegere practică, iar o alegere bună cere atât precizie, cât și context.
8. Relația dintre două variabile: corelația și limitele ei
Corelația poate descrie cât de mult se asociază două variabile într-un eșantion. De exemplu, sportivii cu Deadlift 1RM mai mare ar putea avea, în anumite condiții, rezultate mai bune la o probă de ridicări repetitive. Dar o asociere între persoane nu devine automat o formulă a progresului fiecărui sportiv. Mai mult, relația poate fi afectată de masa corporală, experiență, regulament și selecția participanților. O corelație mare nu identifică singură cauza.
Să presupunem că într-un grup de zece atleți, 1RM-ul la Deadlift este corelat negativ cu timpul la un anumit transport. Aceasta nu demonstrează că creșterea individuală a Deadlift-ului va reduce proporțional timpul la Farmer’s. Sportivii mai puternici pot avea și o tehnică superioară ori experiență de concurs mai mare. De asemenea, diferența dintre timpi poate proveni din condiții de testare care nu au fost standardizate.
Coeficientul de corelație poate fi influențat de valori extreme și de intervalul variabilelor. Dacă analizăm numai atleți de elită cu forță similară, relația poate fi mai slabă decât într-un grup care include începători și avansați. Niciuna dintre estimări nu este automat greșită; descriu populații diferite. Nu trebuie să folosim valorile dintr-un grup pentru predicții fără verificarea compatibilității cu sportivul vizat.
În raportul nostru, o corelație va fi prezentată împreună cu numărul observațiilor, diagrama punctelor și limitările eșantionului. Dacă studiul este exploratoriu, evităm formulări cauzale. Corelația poate sugera o variabilă interesantă pentru un model, dar testul real este capacitatea acesteia de a îmbunătăți predicțiile pentru date noi.
9. Regresia liniară: o hartă aproximativă a relației dintre sarcină și timp
Regresia liniară pornește de la o întrebare simplă: cum variază, în medie, rezultatul când una dintre caracteristicile măsurate se schimbă? Dacă avem mai multe curse de Yoke la distanță fixă și sarcini diferite, putem încerca o relație de forma timp estimat = a + b × sarcină. Coeficientul b descrie modificarea medie asociată unui kilogram suplimentar în intervalul observat, nu o lege fiziologică a fiecărui sportiv. Interceptul a poate să nu aibă semnificație practică dacă sarcina zero este departe de domeniul datelor.
Să presupunem un model pur didactic: t = 7 + 0,035 × m, unde t este timpul în secunde, iar m masa Yoke-ului în kilograme, pentru un traseu identic de 20 metri. La 300 kg predicția este 17,5 secunde, iar la 320 kg, 18,2 secunde. Valorile sunt aritmetic corecte pentru ecuația inventată, dar nu constituie o relație validată. Coeficienții ar trebui calculați pe încercări reale și testați pe rezultate noi înainte de a susține alegerea sarcinii de concurs.
O regresie liniară obișnuită presupune anumite relații între variabile și erori. Dacă timpul crește accelerat după atingerea unei sarcini foarte grele, linia dreaptă poate subestima deteriorarea. Dacă există opriri ori ratări, distribuția devine și mai dificilă. Examinăm diagrama punctelor, reziduurile și stabilitatea coeficienților. Nu alegem modelul liniar fiindcă produce un grafic frumos, ci fiindcă este suficient de util și de justificat în intervalul studiat.
Pentru strongman, regresia simplă poate oferi o primă descriere transparentă, iar faptul că o putem înțelege este un avantaj. Dacă greșește frecvent la încărcături mari, nu o cosmetizăm; recunoaștem domeniul în care funcționează și investigăm metode alternative. Un model inteligibil, cu limite declarate, poate fi mai valoros decât un sistem complex căruia nimeni nu îi poate explica erorile.
10. Reziduurile: locul unde modelul își arată limitele
Reziduul unei observații este diferența dintre rezultatul real și rezultatul calculat de model. Dacă prezicem 18,2 secunde la Yoke și atletul termină în 19,0 secunde, reziduul rezultat − predicție este +0,8 secunde. Pentru timpi, un reziduu pozitiv indică o cursă mai lentă decât prognoza, iar unul negativ o cursă mai rapidă. Nu înseamnă automat că atletul a fost «cu 0,8 secunde mai obosit»; modelul poate fi incomplet sau măsurarea diferită.
Analiza reziduurilor ne ajută să identificăm tipare. Dacă toate cursele de peste 350 kg sunt subestimate, relația dintre încărcătură și timp poate fi neliniară. Dacă erorile cresc când traseul depășește 20 metri, poate fi necesară distanța ca predictor. Dacă apar erori mari numai la un anumit cadru, configurația aparatului poate modifica sarcina. Reziduul este o întrebare nouă, nu doar o notă de penalizare a algoritmului.
Să imaginăm șase observații la aceeași distanță: modelul greșește cu −0,2, +0,1, −0,3, +0,2, +1,8 și +2,3 secunde, în ordinea crescătoare a greutăților. Ultimele două erori sugerează că modelul liniar devine prea optimist la capătul superior al intervalului. Dar șase încercări nu sunt suficiente pentru a decide precis forma relației. Putem arăta problema și colecta mai multe date comparabile înainte de ajustarea unei curbe complicate.
Un model care produce reziduuri mici pe datele de antrenare poate avea totuși erori mari în viitor. Coeficienții au fost ajustați tocmai pentru a minimiza erorile istorice, deci evaluarea exclusiv internă este optimistă. Rezervele de date viitoare și separarea corectă a observațiilor sunt mai importante decât celebrarea unor reziduuri aproape de zero în același fișier.
11. Regresia cu mai multe variabile: utilitate și riscul supraîncărcării
O probă nu depinde doar de sarcină. La Farmer’s, timpul poate varia cu distanța, masa per mână, condiția suprafeței, dificultatea percepută la încălzire și experiența sportivului. Regresia multivariabilă încearcă să estimeze contribuția predictivă a mai multor caracteristici simultan. Ecuația poate avea forma timp = a + b1 × masă + b2 × distanță + b3 × variabilă de suprafață, dar coeficienții rămân descriptivi și depind de cum sunt măsurate datele.
Numărul mare de predictori aduce riscuri. Dacă dispunem de numai 18 curse și introducem 12 variabile, modelul poate învăța particularități întâmplătoare. Mai mult, predictorii pot fi corelați între ei: masa aleasă poate crește într-o perioadă în care sportivul este mai bine pregătit. Coeficienții pot deveni instabili și își pot schimba semnul la adăugarea câtorva încercări. Nu înseamnă că matematica funcționează greșit, ci că datele nu identifică suficient relațiile separate.
O abordare responsabilă pornește cu puține variabile care există înaintea predicției și au justificare sportivă. Pentru Yoke la distanță fixă, poate începem cu sarcina și ultimele rezultate comparabile. Apoi verificăm dacă adăugarea unei variabile oferă predicții mai bune pe încercări noi. Nu includem un indicator numai pentru că software-ul poate calcula un coeficient sau pentru că acesta apare «semnificativ» într-un set mic.
Recomandările despre dimensiunea eșantioanelor pentru modelele predictive subliniază că numărul necesar depinde de complexitate, variație și performanța urmărită [4]. Lucrarea citată are aplicabilitate directă în predicția clinică; principiul general al prevenirii supraînvățării se transferă metodologic. Nu inventăm o regulă universală de zece observații pentru fiecare variabilă în strongman.
12. Relații neliniare: de ce un kilogram în plus nu costă mereu la fel
În apropierea unei sarcini moderate, adăugarea a zece kilograme la Yoke poate avea efect relativ mic. Aproape de limita actuală a atletului, aceeași creștere poate provoca opriri, modificări de pas sau incapacitatea de a finaliza traseul. Relația dintre masă și timp ar putea fi curbată, cu o deteriorare accentuată spre capătul superior. O linie dreaptă poate rata exact zona de interes competițional. Totuși, nu știm forma curbei până nu avem date suficiente.
Putem lua în considerare modele polinomiale simple ori funcții mai flexibile, dar ele se pot comporta neplauzibil în afara intervalului observat. Un polinom poate prezice timpi negativi sau scăderea timpului la sarcini imposibil de mari. Aceasta este o proprietate matematică a extrapolării, nu o descoperire despre fiziologie. Pentru anumite ținte putem impune restricții rezonabile, dar acestea trebuie declarate, nu ascunse într-un software.
La Log for Reps, numărul de repetări poate descrește abrupt pe măsură ce greutatea crește. Dacă un atlet execută zece repetări la 90 kg și șase la 110 kg, nu rezultă că la 130 kg poate executa obligatoriu două. Relația nu este neapărat liniară, iar aproape de maxim apar încercări fără validare. Un model poate fi folosit doar în domeniul unde a fost evaluat, cu prudență suplimentară pentru sarcini noi.
Nu trebuie să selectăm întotdeauna curba cea mai sofisticată. Uneori un tabel cu câteva puncte de referință și intervale de incertitudine este mai onest și mai util. Când domeniul de sarcini este restrâns, datele pot să nu distingă între două forme plauzibile. Recunoașterea acestui lucru protejează sportivul de recomandări bazate pe geometria accidentală a unui grafic.
13. Modele pentru numărul de repetări: de ce contorizarea este specială
Repetările sunt numere întregi nenegative. Un model liniar poate produce o estimare de 7,4 repetări, care poate reprezenta o medie așteptată, dar nu rezultatul oficial al unei încercări. De asemenea, un astfel de model poate prezice valori negative la sarcini foarte mari, incompatibile cu natura țintei. Modele pentru variabile de numărare, inclusiv familia Poisson, pot fi luate în considerare atunci când ipotezele despre distribuție sunt potrivite. Alegerea nu trebuie făcută mecanic.
La Log for Reps există un timp-limită și un număr maxim realist de cicluri. Repetările se influențează reciproc prin oboseală și pauze, astfel încât ipoteza că toate evenimentele apar independent la rată constantă poate fi inadecvată. Uneori un model de count poate descrie media, dar nu poate reproduce bine variația sau acumularea încercărilor invalide. În alte situații este mai util un model care tratează separat ritmul și probabilitatea unei repetări valide.
Un exemplu ipotetic: la 100 kg în 60 secunde, sportivul a obținut repetat șase, șapte sau opt ridicări. Dacă modelul estimează 7,1, întrebarea practică este ce probabilitate atribuie fiecărui număr și cât de bine au fost calibrate aceste probabilități. A prezenta doar «predicție: 7» ascunde variația reală. Un interval plauzibil poate fi mai util decât o singură valoare rotunjită.
Când nu avem multe observații, estimarea distribuției complete poate fi prea fragilă. O medie sau mediană a testelor comparabile, prezentată împreună cu variația lor, poate reprezenta o linie de bază greu de depășit. Modelarea avansată are sens când aduce informație verificabilă, nu doar schimbă forma matematică a aceluiași număr.
14. Probabilitatea unei repetări valide: model logistic, nu promisiune
Uneori întrebarea este binară: va reuși atletul să finalizeze o anumită încercare conform regulilor? Regresia logistică poate estima o probabilitate între zero și unu pe baza caracteristicilor introduse. Pentru un Log greu, predictorii ar putea include sarcina, repetările deja realizate, durata pauzei și rezultate istorice. Dar o probabilitate calculată din puține încercări nu devine automată măsurare obiectivă a capacității din ziua concursului.
Să presupunem că un model ipotetic estimează probabilitate de 0,70 pentru o nouă repetare. Aceasta nu înseamnă că 70% din musculatură este disponibilă și nici că sportivul va reuși în șapte din următoarele zece încercări fără schimbarea condițiilor. Modelul descrie o frecvență estimată într-o populație și configurație de date. Pentru a-i evalua utilitatea, verificăm dacă încercările cărora le atribuie aproximativ 70% succes au efectiv o frecvență apropiată de 70% pe date noi.
Un alt pericol este folosirea ca predictor a informațiilor care apar numai după încercare. Dacă includem în model timpul total al ridicării pe care vrem să o prezicem, obținem aparent performanță remarcabilă, dar nu avem o predicție disponibilă înainte de start. Toate caracteristicile folosite trebuie să fie cunoscute la momentul real al deciziei. Această regulă, simplă în formulare, previne multe modele înșelătoare.
Probabilitatea de succes nu trebuie să autorizeze eforturi riscante. Un algoritm cu valoare mare poate avea eroare, iar durerea, instabilitatea sau semnele medicale nu pot fi reduse la un scor logistic. Modelul poate informa strategia numai în cadrul regulilor și al evaluării tehnice adecvate.
15. Clasamente și punctaj: adversarii schimbă ținta
Un strongman poate câștiga o probă cu un rezultat și poate termina al cincilea cu același rezultat într-o competiție mai puternică. Clasamentul este relativ, nu o măsură izolată a capacității atletului. Dacă dorim să anticipăm punctele unui sportiv, avem nevoie de o estimare a rezultatelor tuturor competitorilor și de regulile pentru egalități, nefinalizări și departajare. Numărul de puncte pentru primul loc poate depinde de numărul participanților și de sistemul utilizat.
Să presupunem un concurs ipotetic cu opt atleți. Atletul A estimează 18 secunde la Yoke, dar alți șapte ar putea înregistra de la 16 la 23 secunde. Locul său nu este fixat de timpul propriu în absența distribuției adversarilor. Dacă aceștia devin mai rapizi decât era anticipat, aceeași performanță poate aduce mai puține puncte. Un model care ignoră competiția însăși poate fi bun la predicția timpului, dar slab la predicția clasamentului.
Problema devine și mai complexă într-un concurs cu cinci probe, deoarece un competitor excelent la Deadlift poate pierde multe puncte la Loading Medley. Este necesar un profil pe probe și un algoritm fidel regulamentului. Nu inventăm punctaje aproximative sub pretextul unei formule generale și nu evaluăm șansele de podium doar după personal record-urile publicate ale adversarilor, care pot proveni din condiții foarte diferite.
O prognoză de clasament ar trebui să fie prezentată ca scenariu incert. Putem calcula rezultate în ipoteze explicite despre adversari, apoi examina sensibilitatea la schimbări. Nu trebuie confundat un loc posibil într-o simulare cu o poziție garantată pe platforma reală.
16. Predicția de bază: ce trebuie să bată orice algoritm sofisticat
Înainte de regresie, random forest sau rețele neuronale, avem nevoie de o metodă foarte simplă de referință. Pentru un test Yoke standardizat, aceasta poate fi ultimul timp valid sau mediana ultimelor trei curse comparabile. Pentru Deadlift maximal poate fi cel mai recent rezultat credibil, ajustat doar prin reguli explicit definite. Pentru Log for Reps poate fi numărul tipic din ultimele sesiuni similare. Acest predictor de bază reprezintă adversarul metodologic al oricărui model mai complicat.
Dacă o aplicație cu cincisprezece variabile prezice Yoke cu eroare medie de 1,4 secunde, iar simpla mediană a ultimelor trei curse are eroare de 1,0 secunde pe aceleași teste viitoare, aplicația nu aduce valoare predictivă. Poate fi interesantă tehnic, dar nu justifică adoptarea ei pentru acea decizie. Comparația trebuie făcută pe aceleași date de evaluare, folosind aceeași definiție a erorii și fără a permite metodei sofisticate să vadă viitorul.
O linie de bază poate fi surprinzător de puternică într-un sportiv cu tehnică și rezultate stabile. Modelele complexe câștigă mai mult când există relații reale între mai multe variabile și suficiente observații pentru a le învăța. Fără această combinație, flexibilitatea devine capacitate de a memoriza zgomotul. În practică, modelele simple sunt și mai ușor de explicat sportivului.
Vom păstra permanent comparația cu această referință, inclusiv după actualizarea algoritmului. Dacă noua versiune nu depășește predictorul simplu la evaluare, nu o prezentăm ca progres. În știința aplicată, complexitatea trebuie să-și câștige locul prin rezultate verificabile.
17. Separarea datelor de antrenare și a celor de evaluare
Cea mai importantă întrebare despre un model nu este cât de bine reproduce trecutul, ci cât de bine anticipează observații pe care nu le-a văzut. Pentru această verificare, o parte din date este păstrată în afara ajustării coeficienților și a alegerii hiperparametrilor. În cazul unui atlet, testele viitoare sunt cea mai relevantă evaluare. Dacă folosim rezultatele lunii octombrie pentru a construi modelul care pretinde că ar fi prezis septembrie, introducem viitorul în trecut.
O strategie didactică este antrenarea modelului pe primele 20 de curse și testarea lui pe următoarele cinci, păstrând ordinea cronologică. Nu este obligatoriu ca această împărțire să fie optimă pentru fiecare set, dar respectă informația disponibilă la momentul prognozei. Putem repeta procedura la mai multe puncte de origine: construim un model pe observațiile 1–15 și prezicem 16, apoi pe 1–16 prezicem 17. Aceasta se numește evaluare progresivă în timp.
Pentru un model destinat sportivilor noi, problema este diferită. Trebuie să păstrăm sportivi întregi în setul de evaluare, astfel încât identitatea și istoricul lor să nu influențeze antrenarea. Dacă același competitor contribuie cu numeroase încercări în ambele seturi, estimarea generalizării poate deveni excesiv de optimistă. Un algoritm poate părea că înțelege strongmanul când, de fapt, recunoaște stilul câtorva persoane.
Nu selectăm variabilele, nu normalizăm datele și nu optimizăm pragurile folosind informații din evaluare înainte de momentul stabilit. Chiar pașii aparent inofensivi, precum calcularea mediei pe întregul fișier pentru completarea valorilor lipsă, pot introduce contaminare. Datele de evaluare sunt valoroase tocmai fiindcă reprezintă o surpriză legitimă pentru model.
18. Validarea încrucișată: utilă, dar nu magică
Validarea încrucișată presupune ajustarea și verificarea modelului în mai multe împărțiri ale datelor. Metoda poate reduce dependența evaluării de o singură selecție de observații, dar nu repară automat structura greșită a eșantionului. Dacă repetările din același set sunt împărțite la întâmplare între antrenare și test, modelul poate vedea condițiile aproape identice și poate învăța informații specifice acelui set. Scorul obținut nu descrie neapărat performanța într-o competiție viitoare.
În datele strongman, alegerea schemei depinde de obiectiv. Pentru generalizarea la sportivi necunoscuți, putem folosi evaluare pe grupuri, păstrând persoanele separate. Pentru prognoza săptămânii următoare a aceluiași sportiv, păstrăm ordinea temporală. Pentru un concurs cu mai multe probe, rezultatele din aceeași competiție pot împărtăși factori de context, iar separarea la nivel de concurs poate fi relevantă.
Un exemplu ipotetic: avem 80 de curse Farmer’s de la patru sportivi. Dacă folosim o împărțire aleatorie a curselor, modelul poate recunoaște caracteristicile fiecăruia. Dacă îl testăm pe cel de-al patrulea sportiv, antrenându-l numai pe primii trei, eroarea poate crește. Această deteriorare nu este un eșec al evaluării; ea arată diferența dintre o prognoză pentru persoane deja cunoscute și una pentru o persoană nouă.
Validarea încrucișată oferă o estimare dependentă de eșantion și de regulile împărțirii. Nu transformă douăzeci de observații într-o sută de observații independente. Dacă toate provin dintr-un singur sezon, nu știm automat cum va funcționa modelul peste doi ani, după schimbarea categoriei de greutate ori a tehnicii. Putem folosi metoda, dar trebuie să raportăm exact ce tip de generalizare a fost testat.
19. Scurgerea informației: când algoritmul vede viitorul fără să recunoaștem
Data leakage sau scurgerea informației apare când în dezvoltarea modelului intră date care nu ar fi disponibile în momentul real al predicției. În sport, fenomenul poate fi subtil. Dacă folosim RPE-ul întregii sesiuni pentru a prezice performanța primei încercări din acea sesiune, predictorul conține informație înregistrată după eveniment. Dacă vrem o prognoză înainte de concurs, nu putem utiliza ordinea finală a clasamentului drept caracteristică.
O formă frecventă este preprocesarea pe întregul set înaintea împărțirii. De exemplu, calculăm media greutăților tuturor sportivilor, inclusiv din evaluare, apoi folosim acea medie pentru a completa valori lipsă în antrenare. Informația despre distribuția setului de evaluare a influențat astfel modelul. Soluția este ajustarea transformărilor exclusiv pe datele de dezvoltare și aplicarea regulilor învățate ulterior pe setul nou.
Există și scurgere prin duplicate. O filmare de Log poate apărea de două ori sub denumiri diferite, iar același eveniment ajunge în antrenare și evaluare. Algoritmul produce o predicție excelentă pentru că a văzut deja rezultatul, nu pentru că a învățat mecanica. Identificatorii stabili ai încercărilor și verificarea duplicatelor sunt condiții elementare ale unei evaluări credibile.
Când un model raportează o acuratețe neașteptat de mare, primul reflex profesional trebuie să fie verificarea protocolului, nu celebrarea tehnologiei. Un rezultat apropiat de perfecțiune în date mici, zgomotoase și heterogene este posibil, dar necesită explicații solide. Modelul trebuie confruntat cu încercări viitoare, separate fără ambiguitate și cronometrare verificată.
20. MAE, RMSE și eroarea pe care o înțelege sportivul
Pentru estimarea timpului, una dintre cele mai accesibile măsuri este eroarea absolută medie, MAE. Calculăm diferența absolută dintre valoarea reală și cea prezisă pentru fiecare încercare, apoi media acestor diferențe. Dacă erorile absolute pentru patru curse sunt 0,3, 0,7, 1,2 și 0,6 secunde, MAE este 0,7 secunde. Aceasta are aceeași unitate cu rezultatul și este ușor de discutat cu sportivul.
RMSE, rădăcina erorii pătratice medii, penalizează mai puternic erorile mari. Într-o strategie de concurs, o prognoză care greșește rar cu cinci secunde poate avea consecințe serioase, chiar dacă în majoritatea curselor este precisă. MAE și RMSE pot oferi perspective complementare. Dar nu sunt același lucru și nu trebuie confundate în rapoarte, mai ales când comparăm modele pe eșantioane cu distribuții diferite.
Pentru repetiții, MAE poate fi exprimat în repetări: modelul a greșit, în medie, cu 1,1 repetări. Pentru masa maximală, eroarea poate fi în kilograme. Pentru șansa unei încercări valide, avem nevoie de indicatori care evaluează probabilități, nu numai numărul de clasificări corecte. Precizia aparentă a procentelor poate masca un model care estimează sistematic șanse prea mari.
Un raport bun include eroarea pe datele de evaluare, numărul predicțiilor, intervalul sarcinilor și rezultatul predictorului simplu de referință. Dacă modelul greșește în medie cu 1,5 secunde, dar concursurile sunt câștigate la diferențe de 0,2 secunde, utilitatea lui pentru alegerea locului poate fi redusă. Eroarea trebuie interpretată prin prisma deciziei.
21. De ce R² nu este suficient și poate fi înșelător
Coeficientul R² este popular deoarece rezumă cât din variația țintei este explicată de model într-un anumit set și în raport cu o referință statistică. Totuși, un R² mare în datele folosite la ajustare nu garantează predicții bune în afara lor. Putem construi o curbă complicată ce trece aproape prin fiecare punct istoric, obținând un rezultat impresionant și eșuând imediat la următoarea încercare. Valoarea trebuie însoțită de evaluare externă sau temporală.
Un R² poate fi și dificil de comparat între seturi diferite. Dacă un eșantion include timpi de Yoke de la zece la șaizeci de secunde, modelul poate explica o mare parte a variației generale chiar cu erori de câteva secunde. Într-un grup de elită cu timpi între 17 și 19 secunde, aceeași eroare absolută poate produce un R² mult mai slab. Acest lucru nu înseamnă automat că modelul al doilea este inferior pentru o decizie concretă.
În plus, un R² calculat pe date viitoare poate fi negativ dacă modelul prezice mai prost decât o referință simplă bazată pe media corespunzătoare. Nu trebuie ascuns sau trunchiat la zero pentru aspectul grafic. Rezultatul arată că metoda are limitări și poate fi nepotrivită pentru populația testată. Examinăm MAE, RMSE, erorile individuale și eventuala părtinire sistematică.
În STRONGMAN DATA LAB vom evita afirmații de tipul «modelul explică 95% din forța atletului» atunci când R² a fost calculat din câteva sesiuni. Variabila-țintă, domeniul sarcinilor și setul de evaluare trebuie explicate. O cifră statistică poate fi precisă matematic și interpretată greșit sportiv.
22. Intervalul de predicție: performanța viitoare nu este o singură cifră
O prognoză punctuală poate spune că un atlet va parcurge Yoke în 18,5 secunde. Dar rezultate viitoare comparabile pot varia din cauza stării zilei, tehnicii, echipamentului și altor factori. Un interval de predicție încearcă să descrie o zonă în care ar putea cădea o observație viitoare, la un nivel de acoperire declarat și în condițiile ipotezelor modelului. Este diferit de un interval de încredere pentru media estimată, care se referă la incertitudinea unei medii, nu la o singură performanță.
De exemplu, un model didactic poate furniza timpul așteptat 18,5 secunde și un interval ilustrativ de 16,9–20,4 secunde. Numerele nu provin din date reale. Ele arată însă de ce o alegere tactică făcută exclusiv pe baza lui 18,5 poate fi fragilă. Un atlet ar putea avea o cursă mai lentă chiar dacă modelul este rezonabil, iar condițiile de concurs pot împinge rezultatul în afara intervalului.
Pentru intervale cu sens, avem nevoie de suficiente observații comparabile și de o metodă de calcul potrivită distribuției erorilor. Dacă intervalele sunt estimate din numai cinci încercări, afirmația că vor conține 90% dintre performanțele viitoare este dificil de verificat. Acoperirea declarată trebuie testată pe date noi. Nu confundăm nivelul teoretic dintr-o formulă cu acoperirea efectivă într-un sport dinamic.
Uneori intervalele largi sunt rezultatul corect. Ele arată că datele nu permit precizia dorită. Nu micșorăm artificial intervalul pentru a produce o predicție mai atrăgătoare. Incertitudinea explicită poate ajuta mai mult decât o cifră exactă, deoarece arată ce decizii sunt robuste la variația rezultatelor și care depind de o zi excepțională.
23. Calibrarea probabilităților: ce înseamnă un model de succes credibil
Un model poate atribui 80% șansă ca un atlet să valideze următoarea repetare. Pentru a evalua această estimare, analizăm un număr suficient de încercări care au primit probabilități asemănătoare și verificăm frecvența reală a succesului. Dacă dintre încercările estimate la aproximativ 80% numai jumătate reușesc, modelul este prea optimist. Un model poate clasifica încercările reușite deasupra celor nereușite și totuși să fie slab calibrat.
Calibrarea contează pentru tactică. Dacă decidem să facem o ultimă încercare într-o fereastră de zece secunde, o probabilitate exagerată ne poate face să supraestimăm beneficiul. În același timp, o prognoză probabilistică nu trebuie să fie transformată într-o autorizație medicală. Dacă sportivul prezintă semne de risc, acestea nu sunt compensate de o șansă de succes afișată ca 92%.
Un exemplu ipotetic: modelul atribuie șanse de 0,70 la zece încercări viitoare comparabile și șapte sunt valide. Rezultatul este compatibil cu calibrarea la acel nivel, dar eșantionul este prea mic pentru o concluzie fermă. Dacă șase au reușit, nu declarăm automat modelul defect; variația aleatoare poate fi substanțială. Evaluarea necesită serii suficient de mari și interpretarea incertitudinii.
Pentru cluburile cu puține încercări, putem evita procente foarte precise și putem folosi categorii descriptive, dacă acestea sunt definite și au demonstrat utilitate. «Probabilitate dificil de estimat» este uneori mai responsabil decât «73,8% șansă de reușită». Modelul trebuie să sprijine decizii, nu să creeze certitudine artificială.
24. Curbe ale performanței în timp: progresul nu este o linie dreaptă
Un atlet poate progresa rapid la începutul unui bloc, poate stagna în mijloc și poate avea un rezultat foarte bun după recuperare. Dacă ajustăm o dreaptă pe toate sesiunile, putem pierde aceste schimbări și putem prognoza greșit ziua concursului. Seria temporală trebuie interpretată în raport cu fazele programului, încărcările și contextul. Regresia în funcție de dată este o descriere aproximativă, nu dovada că fiecare zi adaugă un număr constant de kilograme.
Să presupunem că timpul mediu la Farmer’s scade în opt săptămâni, dar în săptămânile patru și cinci crește din cauza unui bloc de volum mare. Modelul care folosește numai data poate interpreta acea variație ca zgomot, fără să înțeleagă structura. Adăugarea fazei de antrenament ar putea îmbunătăți explicația, dar nu garantăm că va îmbunătăți predicția. Predictorul trebuie disponibil înaintea rezultatului, iar efectul lui verificat ulterior.
Într-un program real, schimbările sunt uneori intenționate. Off-season-ul poate favoriza hipertrofia fără să urmărească un record săptămânal la Yoke. O descărcare poate produce o accelerare temporară a mișcării prin scăderea oboselii. Modelele care ignoră obiectivul blocului pot considera rezultatele intermediare drept eșec și pot recomanda ajustări nepotrivite.
Un model temporal practic ar putea utiliza o mediană mobilă sau o tendință simplă pe câteva teste. Dar dacă fereastra este aleasă după ce observăm rezultatele, riscăm supraajustarea. Înainte de a raporta o îmbunătățire predictivă, testăm mai multe prognoze efectuate în ordine cronologică. Evoluția individuală este o succesiune de adaptări și contexte, nu o obligație de a urma o linie statistică elegantă.
25. Media mobilă și actualizarea continuă a prognozei
Media mobilă este unul dintre cele mai accesibile instrumente pentru sportivii care colectează date consecvent. În loc să folosim toate încercările din ultimii trei ani, calculăm media sau mediana ultimelor trei până la cinci încercări comparabile. Scopul este să oferim o descriere a nivelului recent care se actualizează odată cu antrenamentul. Dar alegerea ferestrei implică un compromis: una scurtă reacționează rapid la schimbări și este mai sensibilă la zgomot, iar una lungă este stabilă, dar se adaptează lent.
Considerăm timpi ipotetici la Farmer’s 20 metri, 110 kg pe mână: 18,2, 17,8, 18,0, 17,4, 17,6 și 17,2 secunde. Ultimele trei au media 17,4 secunde, în timp ce toate șase au media aproximativ 17,7 secunde. Cele două numere răspund unor întrebări ușor diferite. Prima descrie forma recentă; a doua include și o parte a istoriei mai îndepărtate. Niciuna nu constituie o predicție cu garanție de precizie.
O medie mobilă poate fi completată cu variația rezultatelor și cu marcarea schimbărilor de aparat sau program. Dacă trei curse foarte bune au fost realizate pe un traseu nou, nu le combinăm cu timpi vechi fără o verificare a condițiilor. Dacă în mijlocul ferestrei apare o sesiune după competiție, putem consemna contextul, dar nu eliminăm arbitrar observația numai pentru a obține o medie convenabilă.
Pentru strongman, această metodă simplă este adesea suficientă pentru o decizie de antrenament. Dacă un model mai complex nu prezice mai bine viitoarele încercări decât mediana ultimelor trei, îl putem lăsa deoparte. Monitorizarea trebuie să reducă incertitudinea relevantă, nu să amplifice complexitatea administrativă.
26. Învățarea din date puține: regularizarea ca protecție imperfectă
Când avem multe caracteristici și puține observații, coeficienții unui model pot deveni instabili. Regularizarea penalizează modelele excesiv de complexe și poate limita variațiile nejustificate ale coeficienților. Metode precum ridge sau LASSO sunt exemple bine cunoscute, iar lucrarea lui Tibshirani a descris selecția și contracția coeficienților prin LASSO [5]. Aceste tehnici nu creează informație nouă; ele introduc constrângeri pentru a reduce riscul supraajustării.
Un model de Farmer’s poate include sarcina, distanța, masa corporală, RPE, timpul pickup-ului și istoricul ultimelor sesiuni. Dacă toate sunt introduse pentru zece încercări, putem obține predicții extrem de sensibile la modificarea unui singur rând. Regularizarea poate stabiliza unele rezultate, dar nu dovedește că variabilele selectate sunt cauzele fizice ale performanței. Coeficienții reflectă și tipul penalizării și distribuția eșantionului.
Valoarea parametrului de regularizare trebuie aleasă folosind o procedură de evaluare corectă, de preferință în interiorul datelor de dezvoltare, fără a consulta testele viitoare. Dacă încercăm zeci de variante și alegem retrospectiv pe aceea care a prezis cel mai bine un concurs deja încheiat, putem supraajusta inclusiv procesul de selecție. Evaluarea finală trebuie să rămână separată de optimizare.
În practica unui singur atlet, regularizarea poate fi utilă când există zeci ori sute de sesiuni comparabile. Cu cinci încercări de Log, nu transformă modelul într-un calculator fiabil al numărului viitor de repetări. Uneori soluția corectă este reducerea numărului de predictori și colectarea unor observații relevante suplimentare, nu introducerea unui algoritm nou.
27. Random forest: flexibilitate, dar nu magie sportivă
Random forest combină mai mulți arbori de decizie pentru predicții sau clasificări. Metoda popularizată de Breiman [6] poate reprezenta relații neliniare și interacțiuni fără să impună dinainte o singură ecuație liniară. Într-un proiect de strongman, ar putea explora cum se schimbă timpul Yoke în funcție de sarcină, distanță, experiență și condiții. Totuși, flexibilitatea vine cu necesitatea unor date suficient de multe și suficient de variate pentru a evalua generalizarea.
Un arbore de decizie poate învăța reguli precum «dacă sarcina este peste 340 kg și distanța peste 20 metri, timpul tinde să fie mai mare». Dar pragurile pot proveni din structura accidentală a eșantionului. Cu date puține, un arbore poate memoriza observații individuale, iar o pădure poate reduce doar parțial instabilitatea. Nu putem interpreta fiecare despărțire ca lege biomecanică sau recomandare de antrenament.
Importanța variabilelor afișată de algoritm trebuie tratată prudent. Dacă masa corporală apare drept predictor puternic, nu rezultă că un atlet trebuie să își modifice greutatea pentru a obține timpul estimat. Poate fi asociată cu nivelul de forță, experiența ori categoria competițională. Predicția și intervenția sunt lucruri diferite, iar un random forest nu elimină confuzia cauzală prin complexitatea sa.
Înainte de adoptare, comparăm modelul cu o regresie simplă și cu predictorul de bază, pe încercări viitoare. Dacă performanța suplimentară este mică sau inexistentă, transparența unui model mai simplu poate fi preferabilă. Nu trebuie să folosim machine learning doar pentru că termenul sună mai modern decât «mediana ultimelor trei curse».
28. Rețelele neuronale și limitele bazelor de date mici
Rețelele neuronale pot aproxima relații foarte flexibile și pot integra intrări complexe, inclusiv secvențe video sau date temporale. În proiectele cu imagini multe și etichetări consecvente, aceste instrumente pot avea aplicații promițătoare. Dar un club care are douăzeci de curse Yoke și zece seturi Log nu deține un volum de date care să justifice antrenarea de la zero a unui sistem mare pentru prognoză numerică. Riscul memorării istoricului și al eșecului pe noi încercări este considerabil.
Când un model preantrenat analizează video-ul, trebuie să verificăm dacă rezultatele sale rămân corecte la obiecte voluminoase, la aparate diferite și la mișcări în afara exemplelor obișnuite. Episodul opt a arătat că un reper anatomic estimat greșit poate produce viteze sau unghiuri aparent precise. Dacă acele măsurători devin intrări într-un al doilea model, eroarea este propagată, nu anulată. Un predictor final poate fi sofisticat și totuși alimentat cu informație slabă.
Explicabilitatea contează pentru decizie. Dacă modelul recomandă reducerea sarcinii la Log cu zece kilograme, antrenorul trebuie să știe pe ce informații se bazează și ce incertitudine are. O rețea care produce un număr fără evaluare externă nu poate înlocui verificarea tehnică și starea sportivului. Automatizarea unei concluzii fragile nu o face mai sigură.
Pentru moment, în strongmanul de club, algoritmii simpli și bine validați pot fi o alegere superioară. Dacă ulterior există mii de încercări standardizate și rezultate independente, comparația se poate relua. Tehnologia ar trebui introdusă după apariția unei întrebări la care poate răspunde, nu înaintea datelor care i-ar permite răspunsul.
29. Date grupate și modele cu efecte individuale
În proiectele cu mai mulți sportivi, rezultatele din aceeași persoană tind să se asemene mai mult decât rezultatele unor persoane diferite. Modelele ierarhice sau cu efecte mixte pot reprezenta diferențe între sportivi și relații comune, dacă datele sunt suficiente. De exemplu, putem permite fiecărui atlet un timp de referință propriu la Yoke și putem estima separat o relație medie cu sarcina. Aceasta este mai realist decât a presupune că toți încep de la același nivel.
Un model poate estima un efect mediu al încărcării și variații individuale în jurul lui. Dar dacă avem numai trei sportivi și câteva încercări, estimarea diferențelor individuale va fi foarte incertă. Nu putem folosi o formulă ierarhică drept scuză pentru eșantioane insuficiente. Structura statistică ajută la organizarea informației existente, dar nu inventează participanți suplimentari.
Să presupunem că unul dintre atleți progresează la Farmer’s în timp ce altul rămâne stabil. O medie de grup poate arăta un progres moderat și poate ascunde ambele traiectorii. Modelele cu efecte individuale pot face această diferență mai vizibilă, dar interpretarea cauzală rămâne condiționată de program, sarcini și context. Un efect statistic al datei nu dovedește că toate antrenamentele din interval au fost eficiente.
Pentru predicție, trebuie decis dacă vrem să estimăm o nouă încercare a unui atlet cunoscut sau performanța unui atlet nou. Modelele pot avea acuratețe diferită în aceste două situații. Evaluarea trebuie să reproducă întrebarea: separare temporală pentru sportiv cunoscut ori separare pe sportivi pentru generalizare. Fără această alegere, rezultatul modelului poate fi interpretat greșit.
30. Transferul dintre probe: ce poate anticipa un Deadlift despre Atlas?
Strongmanul combină probe cu cerințe parțial suprapuse. Forța de extensie, stabilitatea, priza și tehnica pot influența mai multe evenimente, dar în proporții diferite. Un Deadlift 1RM mare poate fi relevant pentru anumite ridicări, fără a determina automat rezultatul la Atlas Stones ori Farmer’s. Relațiile dintre probe trebuie evaluate empiric și contextual. Revizuirea biomecanicii strongman [1] arată că mișcările nu sunt variante identice ale aceleiași sarcini.
Pentru a investiga transferul, putem compara rezultate ale acelorași sportivi în exerciții diferite, cu regulamente și încărcări documentate. O corelație dintre Deadlift și Sandbag Pickup poate sugera abilități comune, dar nu dovedește că progresul unuia produce în mod necesar progresul celuilalt. Mărimea corporală, tehnica și experiența pot explica o parte din relație. În plus, un model între sportivi nu trebuie aplicat automat la evoluția în timp a unei persoane.
Un exemplu ipotetic: un atlet crește Deadlift-ul de la 250 la 270 kg, dar timpul la Atlas 120 kg rămâne aproape identic. Aceasta nu înseamnă că progresul de forță este inutil. Poate că proba Atlas este limitată de poziționare ori de tranziția către extensie. Din punct de vedere predictiv, modelul construit numai pe Deadlift va greși tocmai pentru că omite specificitatea obiectului.
Un sistem bun poate păstra un profil separat pentru ridicări, transporturi, împingeri și încărcări, apoi poate analiza relațiile unde există date suficiente. Dacă un indicator transversal nu îmbunătățește predicția viitoare, nu îl păstrăm doar pentru că are o explicație teoretică atrăgătoare. Transferul este o ipoteză de testat, nu un beneficiu garantat.
31. Datele de competiție și problema selectării participanților
Rezultatele publicate în concursuri pot părea ideale pentru modelare deoarece sunt oficiale și se referă la performanțe competitive. Totuși, ele provin dintr-o selecție: participă sportivi care au fost invitați, au putut ajunge, nu s-au retras și au respectat regulile. Dacă analizăm numai finaliștii, excludem sportivii cu nefinalizări sau accidente și putem crea o imagine incompletă. Nu este doar o problemă de număr de date, ci de reprezentativitate.
Într-o competiție, atleții pot alege strategic sarcini diferite. Cineva poate evita o încercare maximală suplimentară deoarece a asigurat punctajul necesar; altcineva poate încerca o greutate peste posibilitățile curente pentru a recupera locuri. Dacă folosim cea mai mare greutate validă drept măsură perfectă a capacității maxime, ignorăm aceste decizii. Rezultatul oficial este real, dar nu reprezintă întotdeauna limita fiziologică precisă.
Un model construit din rezultate de elită poate fi nepotrivit pentru debutanți. La fel, o bază cu preponderență sportivi foarte grei nu trebuie aplicată fără verificare unei categorii ușoare. Vârsta, experiența, regulamentul și configurația probelor afectează domeniul de utilizare. Trebuie descrisă populația, nu doar performanța medie.
Dacă dorim o prognoză pentru un concurs nou, evaluăm cât de asemănătoare sunt probele și competitorii cu cei folosiți la construire. Când lipsesc informațiile despre echipament ori când formatul este inedit, incertitudinea trebuie majorată în interpretare. Nu avem dreptul să ascundem lipsa de reprezentativitate sub un număr precis de zecimale.
32. Date lipsă, abandonuri și rezultatele de tip DNF
În strongman, un atlet poate să nu termine o cursă în timpul-limită sau poate să nu valideze nicio repetare. Aceste situații nu trebuie tratate ca observații obișnuite cu timpul zero. Dacă un competitor parcurge numai 12 din 20 metri înainte să expire 60 secunde, un model de timp până la finish nu are un rezultat numeric complet. Înregistrăm distanța realizată, limita temporală și statutul DNF, păstrând informația în forma ei reală.
Eliminarea tuturor nefinalizărilor poate produce un model prea optimist, deoarece rămân numai încercările de succes. În schimb, înlocuirea fiecărui DNF cu exact 60 secunde presupune că timpul real de finalizare ar fi fost același pentru toți și că ar exista un finish, ceea ce poate fi fals. Modelele pentru date cenzurate ori analiza separată a probabilității de finalizare pot fi mai potrivite, dacă avem suficiente observații.
Lipsa unei filmări nu este același lucru cu un DNF. Lipsa unui timestamp din cauza unei camere defecte nu înseamnă că atletul nu a executat proba. Un câmp de statut poate diferenția neparticiparea, nefinalizarea, invalidarea, lipsa măsurării și retragerea medicală. Aceste categorii previn concluzii bizare, precum declararea unei curse de zero secunde drept nou record.
Când datele sunt puține, uneori nu există o soluție statistică robustă pentru fiecare tip de lipsă. Putem limita modelul la o țintă mai clară și putem raporta câte observații au fost excluse și de ce. Transparența este preferabilă completării imaginative a unor rezultate pe care nimeni nu le-a măsurat.
33. Studiu de caz ipotetic: predicția rezultatului la Deadlift for Max
Considerăm un atlet care pregătește o probă de Deadlift maximal și are în ultimele luni rezultate la încărcări și seturi submaximale, plus două maxime validate. Într-un jurnal ipotetic apar 240 kg pentru trei repetări la RPE 8, 250 kg pentru două repetări la RPE 9 și o ridicare validă de 270 kg într-un test anterior. Nu putem transforma automat aceste observații într-un maxim sigur de 280 kg în concurs. Relația dintre repetări, RPE și 1RM diferă între persoane și variații de exercițiu.
Un model simplu poate utiliza ultimul maxim valid drept referință și poate trata seturile recente drept informații de context. Dacă estimarea rezultatului la concurs este 275 kg, trebuie precizat cum a fost calculată și care sunt limitele. Un interval larg, de exemplu 260–285 kg într-un scenariu pur ilustrativ, poate reflecta incertitudinea metodei. Nu îl prezentăm drept interval statistic calibrat dacă nu am evaluat distribuția erorilor pe suficient de multe competiții comparabile.
Alegerea încercărilor este o problemă tactică separată. Prima greutate ar putea urmări un rezultat sigur, a doua o poziție competitivă, iar a treia o îmbunătățire în funcție de adversari. Chiar dacă modelul ar prezice cu precizie maximul final, nu ar putea automat stabili ordinea optimă fără să cunoască probabilitățile validării, regulamentul și punctajele. O predicție a capacității nu este o strategie completă de concurs.
Dacă după competiție sportivul validează 265 kg, înregistrăm eroarea prognozei și cauza cunoscută a eventualelor încercări nereușite. Nu rescriem retrospectiv predicția la 265 pentru a arăta că modelul a avut dreptate. Prin păstrarea valorilor emise înainte de concurs construim un istoric verificabil și putem decide dacă metoda este mai bună decât folosirea ultimului rezultat valid.
34. Studiu de caz ipotetic: Farmer’s Walk și diferența dintre medie și risc tactic
Un competitor se pregătește pentru Farmer’s Walk la 130 kg per mână pe 20 metri. În cinci curse comparabile obține 17,2, 17,9, 16,8, 18,1 și 17,4 secunde. Media este aproximativ 17,5 secunde, dar variația se întinde pe 1,3 secunde. Dacă un model simplu prezice 17,5, această valoare nu garantează că următoarea cursă va fi aproape de medie. Pentru clasament poate conta dacă sportivul își asumă un start agresiv sau preferă o execuție repetabilă.
Să presupunem că analiza video identifică drop-uri în cursele mai lente. Un model care include numărul de drop-uri explică foarte bine timpul istoric, dar nu poate folosi numărul efectiv de drop-uri înainte de cursă, deoarece acesta nu este cunoscut încă. Pentru o prognoză prospectivă putem utiliza frecvența anterioară a drop-urilor, încărcarea și condițiile de start. Distincția dintre predictor disponibil și rezultat intermediar ulterior este esențială.
Un model poate estima separat probabilitatea de finish fără drop și timpul în acea situație. Dar pentru a reuni informațiile avem nevoie de suficiente observații în ambele categorii. Dacă sportivul a avut un singur drop în douăzeci de încercări, modelarea detaliată a probabilității poate fi prea nesigură. O estimare modestă, acompaniată de un scenariu în care apare o oprire, poate fi mai utilă pentru planificare.
După concurs, verificăm timpul, opririle și diferența față de prognoză. Dacă modelul a greșit fiindcă traseul avea altă suprafață, nota de context este parte din evaluare. Nu tratăm o singură cursă lentă ca dovadă că sportivul a regresat. O prognoză poate eșua într-o zi și rămâne folositoare pe termen lung, dar acest lucru trebuie demonstrat prin erori acumulate.
35. Studiu de caz ipotetic: Log for Reps, ritm și probabilitatea ultimei încercări
Imaginăm o probă de Log cu 110 kg pentru 75 secunde. Sportivul are în ultimele antrenamente șase, șapte, șase și șapte repetări validate, cu intervale variabile între ele. Un predictor naiv ar anticipa șase sau șapte repetări. Un model mai complex ar putea analiza timpul primelor trei validări și dificultatea percepută, dar aceste informații devin disponibile numai după începerea probei. Trebuie distinse două obiective: predicția înainte de start și actualizarea predicției în timpul desfășurării.
Într-un scenariu ipotetic, sportivul validează a treia repetare la secunda 31, iar modelul actualizat estimează o probabilitate moderată de a ajunge la șapte. Acest procent ar trebui să provină din multe seturi comparabile; nu îl inventăm din trei timestamp-uri. Dacă istoricul conține numai patru seturi, putem formula mai onest un interval de rezultate observate și discuta strategii posibile. A pretinde precizie de 78,6% ar ascunde lipsa datelor.
Ritmul inițial poate anticipa numărul final, dar poate reflecta și strategia. Un atlet care pornește mai lent poate economisi energie pentru sfârșit, iar altul poate pierde ocazia unei repetări. Dacă tratăm timpul primelor trei repetări ca o cauză simplă a numărului final, riscăm să ignorăm diferențele dintre sportivi și sarcini. Modelele tactice trebuie evaluate pe rezultate noi și pentru regulamente specifice.
În concurs, un sistem statistic nu trebuie să distragă sportivul cu grafice complicate în timpul ridicărilor. Valoarea lui principală poate fi în pregătirea anterioară: exersarea unui ritm care produce repetări valide, analiza intervalelor și înțelegerea variabilității. Datele pot susține tactica, dar nu înlocuiesc controlul implementului și semnalul arbitrului.
36. Studiu de caz ipotetic: Yoke pe 20 metri și extrapolarea din încărcături ușoare
Un atlet are timpi de Yoke de 15,2 secunde la 260 kg, 16,8 la 300 kg și 19,1 la 340 kg, toate pe 20 metri. O linie ajustată aproximativ poate sugera un timp la 360 kg. Dar nu știm dacă între 340 și 360 kg apar opriri sau instabilitate care schimbă brusc relația. Cu trei puncte, o curbă neliniară complexă nu este justificată. Predicția pentru 360 kg trebuie numită extrapolare, nu rezultat aproape cert.
Să presupunem că o estimare simplă oferă 20,3 secunde, iar sportivul realizează 23,0. Diferența nu dovedește singură că modelul «nu funcționează deloc». Poate că sarcina a depășit pragul la care tehnica obișnuită poate fi menținută. Poate că frame-ul era diferit ori sportivul era obosit. Examinăm contextul, încercările de control și dacă aceeași eroare se repetă la alte sarcini mari.
Pentru decizii, putem prezenta intervale condiționale: «dacă ritmul rămâne asemănător cu cel observat, timpul ar putea fi în jurul valorii estimate; dacă apar opriri, prognoza devine nesigură». Nu transformăm scenariile în intervale probabilistice calibrate decât dacă metoda le justifică. Uneori cel mai util sfat statistic este că lipsesc încercări relevante în apropierea sarcinii de concurs.
Dar testarea suplimentară trebuie planificată cu grijă. Nu recomandăm încercări maximale zilnice pentru a îmbunătăți coeficienții. Un test submaximal intermediar, o sesiune tehnică sau un test de referință deja inclus în program poate reduce incertitudinea cu un cost acceptabil. Calitatea deciziei trebuie să fie proporțională cu oboseala produsă de colectarea datelor.
37. Simularea concursului: rezultatele tuturor probelor devin un clasament
Pentru o competiție cu cinci probe putem construi un simulator simplu care primește estimări ale fiecărui rezultat, aplică regulile oficiale de clasare și calculează punctajul total. Pentru o simulare probabilistică ar trebui să includem și variabilitatea rezultatelor, nu doar valorile lor centrale. Scopul este să observăm în ce scenarii sportivul poate urca sau coborî în clasament, nu să declarăm viitorul fixat matematic.
Un exemplu pur didactic cu opt sportivi și cinci probe poate genera mii de combinații de timpi și greutăți posibile, dacă avem distribuții plauzibile pentru fiecare participant. Din fiecare combinație rezultă punctele conform regulamentului, apoi o distribuție a locurilor. Dar numărul mare de simulări nu înseamnă că estimările inițiale sunt corecte. Putem simula de un milion de ori o ipoteză greșită și obținem doar o eroare foarte bine repetată.
Dependențele dintre probe contează. Un atlet care se accidentează ori acumulează oboseală poate performa mai slab în mai multe probe consecutive. Dacă simulatorul presupune rezultate complet independente, poate subestima asemenea scenarii. Invers, tacticile de conservare a efortului pot corela alegerile între evenimente. Modelul trebuie să descrie ipotezele și să verifice dacă rezultatele simulate seamănă cu competițiile reale.
Pentru un club mic, poate fi suficient să construim câteva scenarii explicite: optimist, central și dificil, fără probabilități artificiale. Vedem unde se câștigă cele mai multe puncte și ce probe au variație mare. O astfel de analiză poate ghida pregătirea, deși nu trebuie confundată cu o estimare validată a șanselor de podium.
38. Monte Carlo: un milion de simulări nu repară datele proaste
Simularea Monte Carlo generează repetat valori din distribuții specificate și calculează rezultatele corespunzătoare. Metoda este utilă pentru explorarea incertitudinii, dar depinde de ipotezele introduse. Dacă estimăm greșit variația timpilor Farmer’s ori ignorăm posibilitatea DNF, distribuția locurilor simulate poate fi prea optimistă. Numărul repetărilor de calcul reduce eroarea numerică a simulării, nu eroarea datorată modelului de intrare.
Într-un scenariu ipotetic, stabilim timpul Yoke al unui atlet în jur de 19 secunde, cu variație de la o cursă la alta. Putem genera multe timpuri posibile și le putem compara cu rezultate estimate ale adversarilor. Dar dacă aceștia au personal record-uri de pe alte suprafețe, distribuțiile alese pot fi nepotrivite. Precizia procentului de podium afișat depinde în primul rând de datele competitorilor, nu de puterea procesorului.
Pentru o simulare responsabilă, testăm sensibilitatea la schimbarea ipotezelor. Dacă probabilitatea de podium trece de la 15% la 60% atunci când modificăm puțin variația adversarilor, rezultatul este fragil. În acest caz, nu ar trebui să publicăm un singur procent precum «42,3%» fără explicații. Mai util este să spunem că estimarea depinde puternic de informațiile incomplete despre competitori.
O simulare trebuie să fie verificabilă: sursa valorilor, regulile clasamentului, tratamentul egalităților, DNF și dependențelor. Dacă aceste elemente nu sunt disponibile, putem publica scenarii ilustrative etichetate ca atare. Nu prezentăm numere generate din ipoteze convenabile ca rezultate măsurate ale unui model validat.
39. Evaluarea predicției în sezon: jurnalul prognozelor înghețate
O metodă simplă de a evita retrospectiva convenabilă este păstrarea prognozelor înaintea fiecărei competiții. Notăm data, ora, versiunea modelului, datele disponibile și rezultatul anticipat, eventual cu un interval de incertitudine. După concurs adăugăm rezultatul real și calculăm eroarea. Nu modificăm predicția originală pentru a o apropia de realitate. Această disciplină creează o istorie credibilă de performanță a modelului.
Să presupunem zece predicții precompetiționale de Deadlift for Reps. Dacă modelul a anticipat de două ori prea multe repetări și de trei ori prea puține, vom analiza distribuția erorilor, nu doar media. O medie a erorilor semnate aproape de zero poate ascunde greșeli mari care se anulează reciproc. De aceea raportăm eroarea absolută și semnul ei separat. Un model echilibrat în medie poate fi inexact în fiecare concurs.
Este important să păstrăm și previziunile pentru probele la care sportivul nu participă ulterior, cu statut corect. Dacă retragerea este medicală ori logistică, nu inventăm un rezultat zero sau un timp de finish. Separăm imposibilitatea de evaluare de eroarea unei predicții asupra unui eveniment care a avut loc. Altfel, selecția observațiilor poate distorsiona evaluarea.
La finalul sezonului comparăm predictorul nou cu metoda de bază, pe aceleași concursuri. Dacă modelul oferă câștiguri modeste, dar repetabile, poate merita păstrat. Dacă performanța sa este instabilă, reducerea complexității poate fi o decizie mai bună. Un sistem capabil să-și recunoască erorile are valoare mai mare decât unul care publică numai previziuni reușite.
40. Detectarea schimbării de regim: când istoricul nu mai descrie atletul actual
Un atlet poate trece printr-o schimbare de tehnică, o accidentare, o creștere sau o scădere semnificativă în greutate ori prin mutarea într-o nouă fază de pregătire. În asemenea situații, istoricul îndepărtat poate fi mai puțin reprezentativ pentru forma actuală. Statistica seriilor temporale poate identifica uneori schimbări de nivel sau de variabilitate, dar nu le poate atribui automat unei cauze. Este nevoie de context pentru a decide dacă modelul trebuie recalibrat.
Să presupunem că atletul își schimbă tehnica de Log, iar timpul de clean scade brusc și rămâne mai mic în următoarele șase sesiuni. Un model construit pe toate încercările de dinainte poate subestima progresul actual. Putem introduce data schimbării ca informație contextuală sau putem acorda mai multă importanță observațiilor recente, însă aceste alegeri trebuie evaluate prospectiv. Nu ștergem istoria veche numai pentru a crea o tendință mai frumoasă.
Invers, un rezultat foarte bun după o săptămână de recuperare nu dovedește schimbarea permanentă a capacității. Poate fi doar o zi favorabilă. Un algoritm excesiv de sensibil poate actualiza prognoza prea agresiv și poate recomanda sarcini nepotrivite. Este nevoie de un compromis între capacitatea de adaptare și stabilitatea modelului, iar alegerea depinde de costul erorilor pentru decizia sportivă.
În proiectul nostru, orice schimbare majoră de implement, regulă, tehnică sau fază de pregătire trebuie consemnată. Dacă rezultatele viitoare deviază sistematic de la predicții, investigăm posibila schimbare de regim înainte de a adăuga predictori arbitrar. Uneori modelul nu este «prost», ci descrie un atlet care nu mai este exact același ca în perioada de colectare.
41. Predicția și monitorizarea încărcării: o relație tentantă, dar fragilă
Dacă avem date de session-RPE, tonaj și rezultate la teste fixe, putem încerca să anticipăm cum va performa sportivul după anumite săptămâni de antrenament. Ideea este atractivă: am vrea să știm când volumul va produce progres și când va deveni prea costisitor. Dar relațiile dintre încărcare, oboseală și adaptare sunt complexe, iar două săptămâni cu aceeași sumă de RPE pot include probe și distribuții foarte diferite [7]. Modelul nu poate reduce această complexitate la o funcție care prezice sigur capacitatea fiziologică.
Un exemplu ipotetic: atletul înregistrează timpi de Yoke mai lenți după săptămâni de peste 3.500 AU și mai rapizi după săptămâni sub 2.500 AU. O corelație simplă ar putea sugera că încărcarea mare «dăunează» performanței. Dar sportivul poate fi într-un bloc de acumulare intenționat, iar adaptarea să devină vizibilă după recuperare. Fără a ține cont de calendar și de obiectiv, modelul poate recomanda sistematic mai puțin antrenament tocmai când sportivul are nevoie de stimul.
Putem construi modele cu întârzieri temporale, în care volumul unei săptămâni este asociat cu performanța uneia ulterioare. Totuși, alegerea întârzierii din date foarte puține poate produce relații întâmplătoare, iar succesul în retrospectivă nu garantează predicție. Verificarea trebuie făcută pe săptămâni viitoare, cu reguli stabilite în avans. Când există schimbări de program sau simptome, acestea trebuie luate în considerare independent de model.
Nu vom interpreta niciun scor de încărcare ca diagnostic al supraantrenamentului sau ca probabilitate medicală exactă de accidentare. Consensurile despre încărcare și riscuri subliniază contextul și limita indicatorilor simpli [8], iar literatura critică a raporturilor acute–cronice evidențiază probleme conceptuale și statistice [9]. Predicția performanței poate fi utilă, dar siguranța și sănătatea necesită o evaluare separată.
42. Decizia sub incertitudine: ce facem când două strategii par apropiate?
Un model poate estima că un start agresiv la Farmer’s va economisi în medie 0,3 secunde, dar va crește variabilitatea timpului și șansa unei opriri. Alt model poate favoriza un start mai conservator, cu rezultat mediu puțin mai lent, dar mai consistent. Alegerea depinde de ceea ce valorizează concursul: timpul minim, evitarea nefinalizării ori punctele obținute față de adversari. Un predictor bun nu poate stabili singur obiectivul tactic.
Să presupunem un concurs ipotetic în care atletul are nevoie de locul întâi la Yoke pentru a urca pe podium. O strategie mai riscantă poate fi atractivă dacă locurile doi și trei nu mai schimbă clasamentul general. Într-un alt scenariu, sportivul poate avea nevoie doar de un finish valid pentru a menține poziția. Aici constanța poate fi preferată. Aceste decizii trebuie luate respectând siguranța și regulamentul, nu doar calculând un timp așteptat.
Putem utiliza scenarii în care aplicăm aceleași reguli de punctaj rezultatelor plauzibile ale fiecărei strategii. Dacă strategia conservatoare produce frecvent un loc bun, iar cea agresivă oferă ocazional primul loc, discutăm explicit compromisurile. Dar fără date suficiente nu atribuim procente precise acestor scenarii. Putem analiza consecințele unor rezultate posibile fără să pretindem că le cunoaștem probabilitățile exacte.
O metodă sănătoasă începe cu stabilirea obiectivului sportiv și cu identificarea unor rezultate inadmisibile: accidentare, pierdere a controlului, invalidări repetate. Abia apoi prognoza ajută la diferențierea opțiunilor rămase. Statistica nu înlocuiește responsabilitatea pentru decizia finală; o face mai explicită.
43. Un protocol de patru săptămâni pentru primul model predictiv
În prima săptămână alegem o singură întrebare, de exemplu estimarea timpului la Farmer’s pe 20 metri la o sarcină fixă. Stabilim regulamentul, modul de cronometrare, aparatul și câmpurile obligatorii. Dacă există istoricul ultimelor luni, verificăm comparabilitatea și eliminăm doar înregistrările care nu răspund țintei, cu motive documentate. Alegem o linie de bază simplă, precum mediana ultimelor trei încercări. Nu încercăm să antrenăm zece algoritmi din primele minute.
În a doua săptămână analizăm distribuția rezultatelor și construim, dacă datele permit, o regresie simplă. De exemplu, putem verifica dacă timpul din cursa precedentă adaugă informație sau dacă încărcarea diferită schimbă predicția. Stabilim dinainte cum va fi calculată eroarea pe încercări viitoare. Dacă avem numai patru înregistrări comparabile, recunoaștem că modelul nu poate fi evaluat riguros și continuăm colectarea.
În a treia săptămână notăm prognoza înaintea unei curse deja incluse în planul de antrenament. Păstrăm timestamp-ul, versiunea și valoarea, apoi comparăm cu rezultatul fără să rescriem istoria. Dacă eroarea este mare, verificăm mai întâi dacă s-a schimbat suprafața, cadrul sau oboseala din sesiune. Un singur rezultat nu decide succesul modelului. Evaluarea trebuie repetată, fără a adăuga încercări maximale doar pentru a alimenta datele.
În a patra săptămână comparăm erorile prognozelor cu cele ale liniei de bază. Dacă modelul nu depășește medianele recente, îl simplificăm. Dacă îmbunătățirea pare constantă, menținem protocolul și colectăm mai multe exemple înainte să formulăm afirmații publice. Patru săptămâni sunt un exercițiu de metodă, nu o dovadă a validității universale. Scopul este învățarea unei discipline predictiv-statistice aplicate.
44. Cum arată un raport care respectă principiile cercetării
Un raport bun precizează populația, perioada, probele, definiția țintei, predictorii disponibili, aparatele și rezultatele excluse. Descrie apoi modelul, metoda de împărțire a datelor, măsurile de eroare și comparația cu o variantă simplă. Pentru modele cu probabilități, adaugă evaluarea calibrării; pentru rezultate continue, analizează erorile individuale și, dacă sunt justificate, intervalele predictive. Cititorul trebuie să poată înțelege cât de diferite sunt datele de dezvoltare față de situația în care modelul va fi folosit.
TRIPOD+AI oferă recomandări de raportare pentru modele predictive dezvoltate cu regresie și machine learning, în context clinic [2]. Nu este un set de norme validate direct pentru strongman, dar principiile de transparență sunt transferabile. A publica doar procentul favorabil al unui algoritm, fără numărul încercărilor și procedura de verificare, ar fi insuficient. Orice autor interesat de credibilitate trebuie să descrie atât procedura, cât și limitările.
Un exemplu de formulare responsabilă ar fi: «Într-un set ipotetic de 40 curse comparabile, metoda A a avut MAE de 0,9 secunde pe ultimele opt, față de 1,1 secunde pentru mediana ultimelor trei». Chiar și această diferență trebuie interpretată cu prudență din cauza eșantionului mic și a posibilelor schimbări de condiție. Nu vom transforma 0,2 secunde într-o «creștere de 18% a preciziei sportive» fără definirea atentă a comparației.
Raportul poate include un tabel cu erorile fiecărei încercări, fără să publice informații personale inutile. Dacă folosim date reale ale sportivilor, consimțământul și regulile de utilizare trebuie respectate. Dacă folosim exemple fabricate pentru instruire, le etichetăm clar. Un model poate fi interesant științific chiar atunci când are eroare mare, dacă ne arată ce informații lipsesc și cum putem îmbunătăți colectarea.
45. Predicția ca instrument de coaching: de la număr la conversație
Un atlet care primește prognoza «Yoke 19,5 secunde» poate fi tentat să o trateze ca promisiune. Antrenorul trebuie să explice că valoarea reprezintă o estimare într-un anumit context, iar schimbările de încărcătură și de suprafață pot altera rezultatul. Dacă există un interval de incertitudine credibil, îl prezentăm. Dacă nu, spunem clar că numărul este doar o referință descriptivă. Comunicarea este parte a aplicării corecte a statisticii, nu un adaos cosmetic.
Când prognoza este mai slabă decât așteptările sportivului, nu trebuie să îi reducem ambiția la nivelul algoritmului. Putem spune că istoricul actual nu susține o predicție mai optimistă, dar următoarele sesiuni pot schimba informația disponibilă. Dacă sportivul dorește să testeze un obiectiv mai greu, decizia trebuie raportată la plan, tehnică și siguranță. Modelul oferă evidență parțială, nu autoritate asupra aspirațiilor individuale.
Când prognoza este foarte bună, nu creștem automat sarcina. Un model poate reflecta o serie de zile favorabile, iar programarea trebuie să includă recuperare și faza sezonului. Predicția nu trebuie să încurajeze încercări maximale neplanificate, mai ales când apar probleme de control sau simptome. Relevanța ei este mai mare în stabilirea unor așteptări realiste și în identificarea domeniilor unde datele sunt insuficiente.
Un dialog eficient poate combina rezultatul anticipat, nivelul de incertitudine și o acțiune concretă: «urmărim încă două curse la această sarcină», «verificăm pickup-ul», «păstrăm testul după recuperare». Modelul devine instrument de învățare împărtășită. Nu trebuie să fie un verdict afișat pe ecran, ci o ipoteză pe care sportivul și antrenorul o pot confirma, respinge sau rafina.
46. Limitele cercetării predictive specifice strongmanului
Strongmanul nu dispune încă de aceeași bază extinsă de date standardizate ca unele sporturi cu competiții foarte omogene. Aparatele, distanțele, încărcăturile, suprafețele și regulile diferă frecvent. Chiar dacă două competiții folosesc numele «Yoke Walk», condițiile nu sunt neapărat interschimbabile. Review-ul biomecanic din 2019 descrie o literatură încă limitată pentru multe probe [1]. Nu putem afirma că există o ecuație predictivă universal validată pentru toate combinațiile întâlnite.
Cercetările viitoare ar putea colecta prospectiv date standardizate despre încărcătură, distanță, timp, încercări invalide, variabile de tehnică și rezultate competiționale. Ar fi important să includă atât sportivi avansați, cât și începători, cu descrierea caracteristicilor relevante. Evaluarea ar trebui realizată pe competiții ori atleți neincluși în dezvoltare. Fără aceste măsuri, modelele riscă să fie doar rezumate elegante ale propriilor date.
Ar fi utile și studii care analizează valoarea adăugată a tehnologiei: îmbunătățește video-tracking prognoza față de simplul timp de pe cronometru? Ajută RPE-ul recent în predicția cursei viitoare? Este un model ierarhic superior ultimei performanțe valide pentru o persoană nouă? Întrebările trebuie formulate înaintea evaluării, iar rezultatele negative publicate la fel de transparent ca cele pozitive.
Până la existența unor astfel de dovezi, cea mai bună metodă rămâne construcția incrementală: definirea probei, colectarea corectă, testarea unei baze simple și evaluarea repetată în viitor. Este mai riguros să avem un model modest și verificabil decât să numim «inteligență artificială sportivă» un scor calculat din câteva încercări necomparabile.
47. Etica predicțiilor: clasificarea sportivilor și riscul etichetelor definitive
Un model care estimează cine va câștiga o probă poate fi util pentru explorarea strategiilor, dar poate crea și etichete nedrepte dacă este utilizat fără context. Sportivii cu mai puține competiții sau cu acces limitat la echipamente pot avea date mai puține și predicții mai incerte. A-i clasifica drept «fără potențial» din cauza unei baze incomplet populate confundă lipsa informației cu lipsa capacității. Predicția trebuie prezentată ca estimare condiționată de dovezi, nu judecată asupra valorii atletului.
Când comparațiile includ categorii diferite de greutate, experiență și sexe, trebuie verificat dacă modelul performează echitabil în fiecare subgrup relevant. O eroare medie bună pe întregul eșantion poate ascunde erori mari pentru o categorie slab reprezentată. Dacă datele nu permit evaluarea, limitarea trebuie declarată, nu acoperită printr-o generalizare optimistă. Transparența este o condiție atât statistică, cât și etică.
Datele personale, filmările și starea de sănătate necesită protecție. Nu folosim automat informații medicale pentru a îmbunătăți un predictor sportiv și nu difuzăm public istoricul individual fără drepturi și consimțământ adecvate. Un algoritm poate produce rezultate interesante fără ca toate datele sale de intrare să fie publice. În schimb, metodologia și performanța generală pot fi descrise într-o formă care protejează participanții.
În comunicare, evităm concluzii definitive despre talent, inteligență sau caracter dintr-un rezultat. Un sportiv poate progresa prin muncă, tehnică, recuperare și experiență, iar modelele sunt actualizabile. Valoarea statisticii este tocmai capacitatea de a revizui ipotezele în lumina datelor noi, nu de a transforma un clasament probabilistic într-o identitate permanentă.
48. Concluzie: prezicem cu umilință metodologică, nu cu certitudini fabricate
Estimarea performanței este posibilă în anumite limite, dar nu înseamnă ghicitul rezultatului viitor cu precizie garantată. Modelele învață relații din observații, iar aceste observații sunt influențate de regulament, tehnică, aparat, pregătire și eroarea măsurării. O regresie simplă poate fi utilă, un random forest poate surprinde interacțiuni, iar o simulare poate explora clasamente posibile. Niciuna nu este mai solidă decât datele și verificările care o susțin.
Pentru strongman, specificitatea este esențială: nu există un singur coeficient care transformă Deadlift-ul în Atlas, Log-ul în Viking Press sau Yoke-ul în Farmer’s. Rezultatele oficiale, condițiile de testare și variabilitatea individuală trebuie păstrate. Predicțiile au sens când sunt evaluate pe încercări viitoare și comparate cu metode simple. O eroare bine documentată valorează mai mult decât o acuratețe perfectă obținută prin scurgerea informației.
Într-un Strongman Data Lab matur, prognoza este emisă înaintea încercării, cu limite explicite, apoi confruntată cu rezultatul. Se notează diferența, se investighează cauza plauzibilă și se ajustează metoda numai după verificări. Un antrenor care știe când modelul este nesigur poate lua decizii mai bune decât unul impresionat de o cifră exactă. Transparența incertitudinii nu slăbește știința, ci o face utilizabilă.
Episodul zece va încheia seria prin integrarea datelor într-un sistem complet de decizie pentru strongman: indicatori, dashboard, fluxuri de colectare, validare, prognoză și revizuire a programului. De la o repetare filmată la planificarea sezonului, obiectivul rămâne același: măsurăm riguros, interpretăm proporțional cu dovezile și păstrăm atletul, nu algoritmul, în centrul performanței.
Bibliografie științifică
[1] Hindle, B. R., Lorimer, A., Winwood, P., & Keogh, J. W. L. (2019). The Biomechanics and Applications of Strongman Exercises: A Systematic Review. Sports Medicine - Open, 5, 49. https://doi.org/10.1186/s40798-019-0222-z
[2] Collins, G. S., Moons, K. G. M., Dhiman, P., et al. (2024). TRIPOD+AI Statement: Updated Guidance for Reporting Clinical Prediction Models That Use Regression or Machine Learning Methods. BMJ, 385, e078378. https://doi.org/10.1136/bmj-2023-078378
[3] Atkinson, G., & Nevill, A. M. (1998). Statistical Methods for Assessing Measurement Error (Reliability) in Variables Relevant to Sports Medicine. Sports Medicine, 26(4), 217–238. https://doi.org/10.2165/00007256-199826040-00002
[4] Riley, R. D., Ensor, J., Snell, K. I. E., et al. (2020). Calculating the Sample Size Required for Developing a Clinical Prediction Model. BMJ, 368, m441. https://doi.org/10.1136/bmj.m441
[5] Tibshirani, R. (1996). Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
[6] Breiman, L. (2001). Random Forests. Machine Learning, 45, 5–32. https://doi.org/10.1023/A:1010933404324
[7] Bourdon, P. C., Cardinale, M., Murray, A., et al. (2017). Monitoring Athlete Training Loads: Consensus Statement. International Journal of Sports Physiology and Performance, 12(Suppl 2), S2-161–S2-170. https://doi.org/10.1123/IJSPP.2017-0208
[8] Soligard, T., Schwellnus, M., Alonso, J. M., et al. (2016). How Much Is Too Much? (Part 1) International Olympic Committee Consensus Statement on Load in Sport and Risk of Injury. British Journal of Sports Medicine, 50(17), 1030–1041. https://doi.org/10.1136/bjsports-2016-096581
[9] Impellizzeri, F. M., Tenan, M. S., Kempton, T., Novak, A., & Coutts, A. J. (2020). Acute:Chronic Workload Ratio: Conceptual Issues and Fundamental Pitfalls. International Journal of Sports Physiology and Performance, 15(6), 907–913. https://doi.org/10.1123/ijspp.2019-0864
[10] Bland, J. M., & Altman, D. G. (1986). Statistical Methods for Assessing Agreement Between Two Methods of Clinical Measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/S0140-6736(86)90837-8
[11] Sánchez-Medina, L., & González-Badillo, J. J. (2011). Velocity Loss as an Indicator of Neuromuscular Fatigue During Resistance Training. Medicine & Science in Sports & Exercise, 43(9), 1725–1734. https://doi.org/10.1249/MSS.0b013e318213f880
[12] Pareja-Blanco, F., Rodríguez-Rosell, D., Sánchez-Medina, L., et al. (2017). Effects of Velocity Loss During Resistance Training on Athletic Performance, Strength Gains and Muscle Adaptations. Scandinavian Journal of Medicine & Science in Sports, 27(7), 724–735. https://doi.org/10.1111/sms.12678
Mai multe din jurnal
Antrenament
Știința antrenamentului în Strongman - Episodul X: Programarea pentru competiție
Cum construiești un bloc complet de pregătire pentru competiție în Strongman: calendar, probe, volum, intensitate, specificitate, simulări, autoreglare, taper și managementul oboselii.
Antrenament
Știința antrenamentului în Strongman - Episodul IX: Peaking-ul
Peaking-ul în Strongman: cum transformi forma construită în lunile de antrenament într-o performanță maximă în ziua competiției, prin reducerea oboselii, păstrarea adaptărilor și gestionarea specificității.